堆代码网讯
Meta近期更新了旗下商业服务使用条款,新增内容声明公司有权“使用企业账号所属域名、网页或链接下的任意内容,用于Meta旗下产品与服务的供给、开发、优化、调研、训练及完整性维护”。
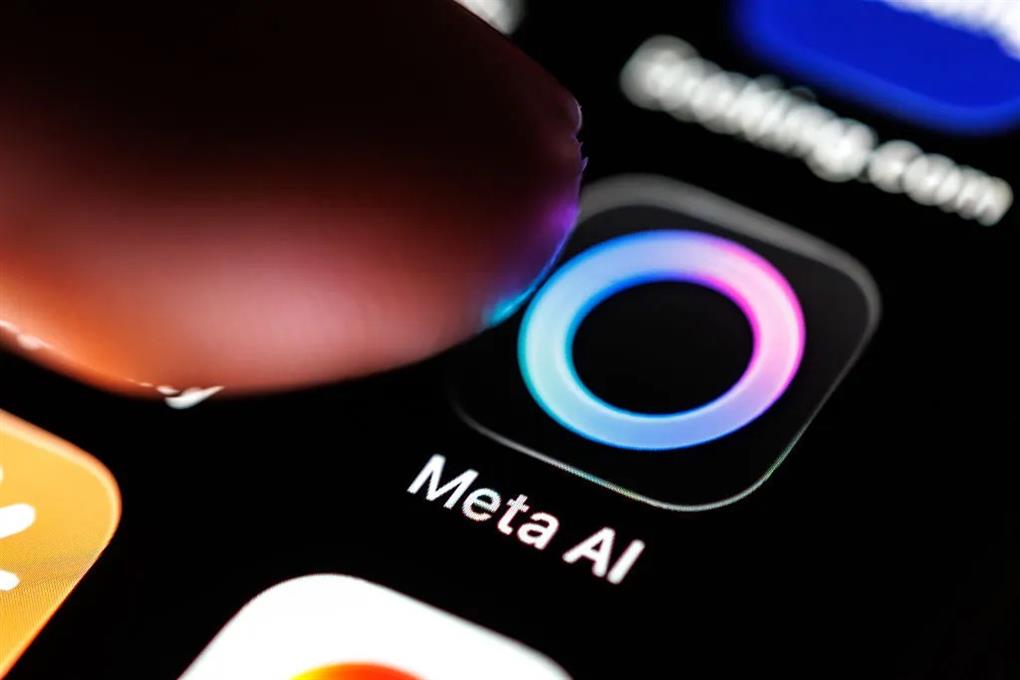
尼曼实验室采访的多位法律专家指出,该条款属于“极具争议的特殊约定”,相当于直接授权Meta抓取所有拥有Meta企业账号的内容出版商的网站内容,用于训练自家AI模型。尽管Meta去年刚打赢了一起备受关注的AI版权侵权诉讼,但目前仍有多起针对它及其他AI企业的相关案件在审理中。不过Meta的发言人此前坚称,本次条款更新并未改变公司网页爬虫的现有运行规则。而据The Verge最新报道,这条引发广泛争议的条款目前已经被Meta正式删除。
Meta在官方声明中表示:“我们收到了大家的反馈,在此作出澄清:此前整合的爬虫相关条款仅适用于我们的广告及商业产品体系,我们已经在条款文本中明确标注了这一适用范围,本次调整完全不会改变Meta网页爬虫的实际运行方式。”
 闽公网安备 35020302035485号