堆代码网讯
Meta超级智能实验室于美国时间周一推出两款全新顶尖大模型——Muse Wonder与Muse Wonder Full,这是该公司首次正式推出前沿级大模型产品。此前Muse Spark主打低延迟轻量化运行,而全新Wonder系列参数规模更大、能力全面升级,基准测试得分更高,在编程等复杂任务上表现更出色。根据Meta在模型卡中公布的内部测试结果,Wonder与Wonder Full的基准性能已与Fable 5.1、GPT-6 Astra处于同一梯队。Meta官方博客中提到:“两款模型共同构成了我们技术缩放路线的关键一步,是迈向个人超级智能的重大跨越。”
性能升级也直接体现在定价上:通过Meta Model API调用的Muse Wonder,输入token定价为每百万4美元,输出token定价为每百万20美元,成本水平与GPT-6 Sol、Opus 5.5基本持平。值得注意的是,Muse Wonder Full仅向Muse Code订阅用户开放,不通过API对外提供服务。两款新模型都将作为底层能力,驱动Muse智能体运行。
延续Meta长期打造可执行长周期任务个人助手的产品思路,本次发布重点强化了模型对用户信息的留存与整合能力,Meta将这一特性命名为“主动记忆”。为验证长时记忆召回效果,Meta引入了专门测试持续学习与记忆构建能力的MemoryBench基准,其内部测试显示,Muse Wonder在该榜单上的得分已经超过Fable、Opus与Astra。
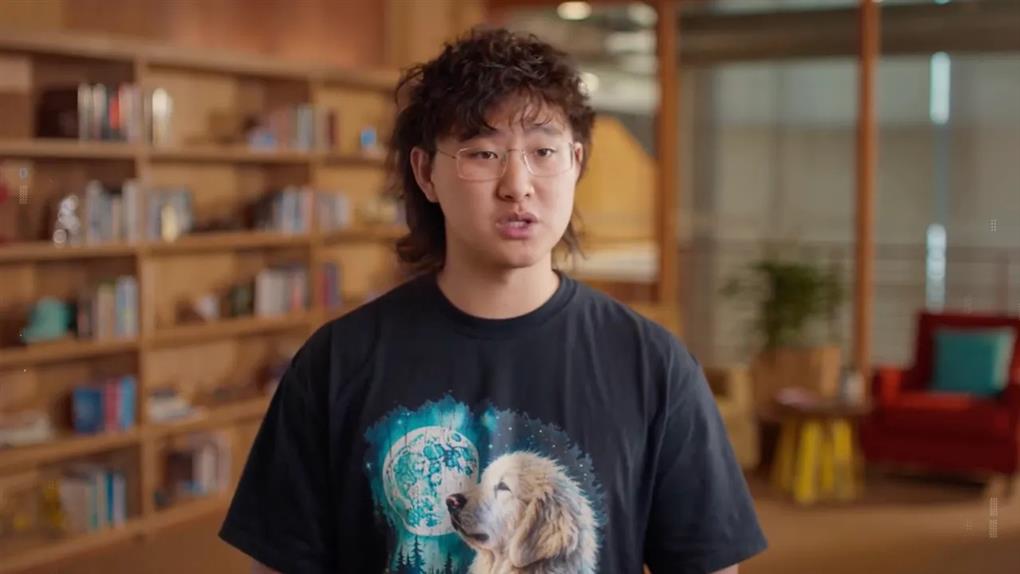
本次发布配套视频中,研究科学家Kavya Kopparapu表示:“我们投入了海量研发资源,确保模型能在数天、数周、数月甚至更长周期里,牢牢记住对你而言重要的信息。”
这两款新模型是Scale AI创始人Alexandr Wang去年8月主导Meta AI业务重组后,Meta推出的首款前沿级大模型。此前重组后的团队已发布轻量化模型Muse Spark与Muse智能体,但始终未推出OpenAI、Anthropic旗下标杆级别的顶尖大模型产品。根据官方博客介绍,两款新模型均在今年刚投入运营的俄亥俄州中部Prometheus数据中心完成训练。
 闽公网安备 35020302035485号