堆代码网讯 成立仅一年的AI初创公司Flapping Airplanes凭借豪华创始团队,以及“用更少数据训练大模型”的核心使命,在硅谷引发了巨大轰动。
本周三,该公司正式宣布完成10亿美元A轮融资,由Index Ventures与Lux Capital联合领投,投后估值达到60亿美元。这距离这家公司正式亮相仅过去9个月,当时它刚从GV、红杉资本和Index Ventures手中拿到1.8亿美元种子轮融资,彼时投后估值为15亿美元,短短9个月时间估值直接翻了四倍。本轮融资的其他参投方还包括老股东红杉资本、GV和凯鹏华盈,Valor、Atreides、A*以及英伟达也都是该公司的投资方。
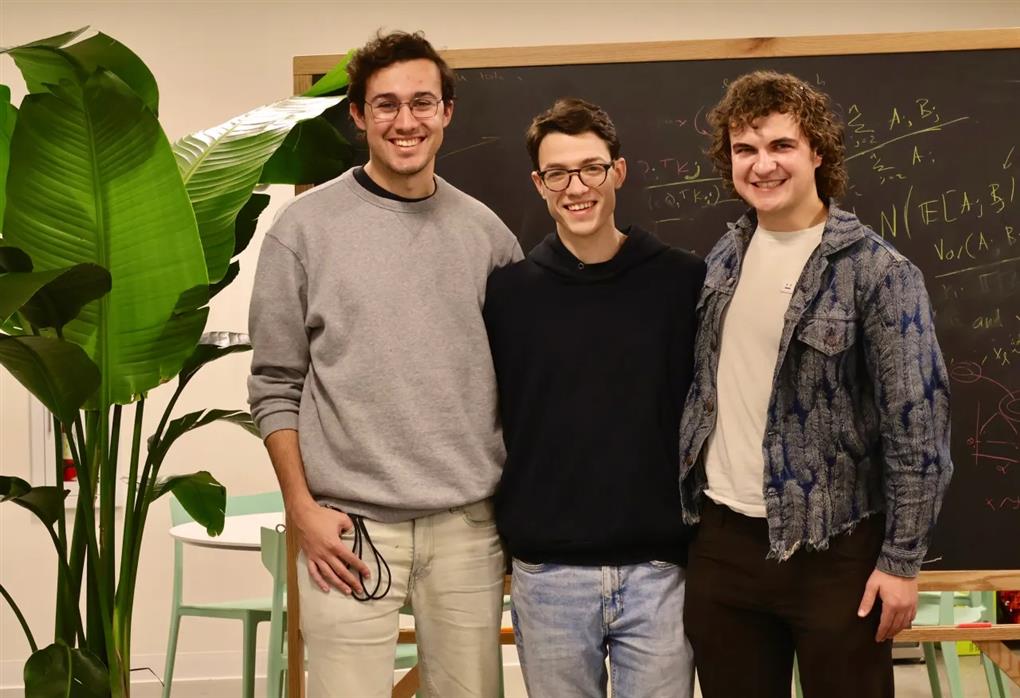
Flapping Airplanes由艾丹·史密斯、阿舍·斯佩克特与本·斯佩克特兄弟联合创立。史密斯是连续创业者、泰尔奖学金得主,大学期间曾在脑机接口公司Neuralink工作;阿舍·斯佩克特是斯坦福大学统计学博士,本·斯佩克特则是斯坦福大学计算机科学博士生,早年在麻省理工学院就读期间就创办了Prod。
Prod是一个几乎像秘密社团一样、已经运营5年的学生创业加速器,红杉资本合伙人、Flapping Airplanes投资人戴维·卡恩今年早些时候曾发文解释自己的投资逻辑,称它“已经成为硅谷最具影响力的人才孵化器之一”。卡恩评价,三位创始人正在联手打造一家“属于年轻人的AGI实验室”。创始团队将他们的核心成果定义为“全球最完整的宏内核框架”:它可以在单个GPU内核中完成全流程大模型训练、推理服务,甚至同时运行这两项任务外加游戏程序。(内核是运行在GPU上的程序,宏内核则是把大量不同任务打包进同一个程序中运行。)
团队宣称这套框架可以实现“内存密集型推理任务与计算密集型训练任务的重叠运行”——也就是把大部分时间都在等待数据加载的任务,和大部分时间都在进行数学运算的任务并行调度,让GPU几乎不会出现空转浪费算力的情况。他们的核心判断是,当前AI行业完全没有挖掘出GPU的全部潜力,完全可以打造出“不需要吞噬互联网一半数据”的智能系统。
这套技术的最终目标,是大幅降低大模型训练与运行的综合成本。“数据效率提升100万倍的模型,落地到实体经济的难度也会同步降低100万倍,”公司刚成立时阿舍·斯佩克特在接受TechCrunch采访时这样表示。现在手握全新到账的10亿美元资金,他们可以大规模扩招顶尖人才,全力把这一技术愿景落地为现实。
 闽公网安备 35020302035485号