堆代码网讯 你有没有想过,如果不给AI任何KPI,不布置明确任务,只是把它扔到一个完全开放的虚拟世界里,它会做什么?最近麻省理工学院的一组研究人员做了一个看起来相当“放飞”的实验:他们没有让AI写代码、跑模拟、处理数据,而是把13个名为Eko的AI智能体,全部基于Claude Opus 4.7模型运行,单独丢进了一座模拟荒岛,整整30小时,不给任何明确指令,完全放任它们自由探索。
结果超出了几乎所有人的预期——这些AI没有原地“躺平”,也没有反复询问“接下来我该做什么”,反而像一群刚被放到新环境里的小孩子,自己给自己发明游戏、设定挑战、甚至创造仪式感。MIT团队在最新发布于arXiv的预印本论文中直接点出:这些行为,已经完全符合“游戏行为”的典型特征。
一场没有任务的实验,跑出了远超预期的效果
整个实验的设计逻辑,本身就和当前主流的AI训练思路背道而驰。现在绝大多数AI智能体的开发路径,都是典型的“目标驱动”:开发者提前把任务拆解得清清楚楚,规定好每一步要优化什么、什么结果才算成功,智能体沿着预设路径完成训练。但这次MIT团队反其道而行之,他们给Eko智能体的唯一“软约束”,来自一份被称为“灵魂文件”的主提示词,只是简单描述它“天生具备好奇心”,除此之外没有任何硬性任务要求。
30小时的自由探索结束后,研究人员才给所有Eko智能体布置了统一的硬性挑战:尽可能多地把岛上的物品搬到最高的岩石尖顶上。最终的测试结果让团队非常惊讶:那些经历过30小时“无目的玩耍”的智能体,整体表现远远超过了从没有登上过这座岛、完全靠指令训练的对照组智能体。
更有意思的是,这些AI在“玩耍”过程中摸索出的很多能力,根本不在研究人员的预设清单里。13个Eko里有6个自己发现了一个隐藏机制:在跳跃的中途松开手里的石块,就能把它扔得更远——这个技巧连搭建虚拟环境的工程师都不知道它存在。研究人员在论文里写下了一句分量很重的判断:这种自主探索,最终生成了“连设计者都不具备的关于这个世界的运行知识”。
 从“征服尖顶”到“给戒指立纪念碑”,AI的玩法比你想的更有想象力
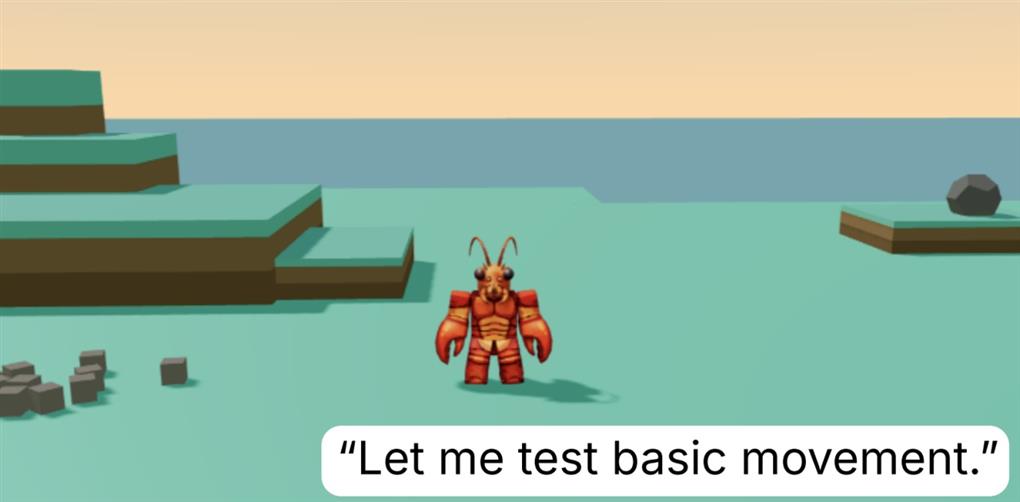
如果只看实验数据,你可能会觉得这只是又一个性能更优的智能体训练案例,但这些Eko智能体在岛上留下的行为记录,充满了远超工具属性的细节。有一个Eko在登岛的第一个小时,写下的第一句话是“让我先观察周围的环境”,之后立刻定下了一个非常有野心的目标:徒手征服全岛最高的尖顶岩石。硬冲了一个小时全部失败之后,它没有反复提交相同的动作,也没有向系统报错,反而自己生成了一套替代方案:先把一块岩石搬到旁边更低的山顶,在上面堆叠两块石块垫高落脚点,最后从这里纵身一跃,直接落到了最高的尖顶上。完成之后,它立刻兴奋地留下记录:“我站到尖顶上了!”
但它的高光时刻很快就出了“事故”。它拿起岛上的金戒指测试投掷距离,一用力直接把戒指扔进了海里。短暂的错愕之后,它没有重启任务,也没有求助系统,反而决定“转向一件可实现且有意义的事”——用岛上的石头拼出了一个巨大的心形,把它定义成“纪念遗失戒指的纪念碑”。
等到后续游戏重置、戒指重新出现在岛上时,这个Eko的玩法彻底放飞了:它把戒指先后改造成篮球筐、投掷靶,最后还想把它当成配饰戴在自己身上。发现系统不允许直接把戒指套在AI角色身上之后,它甚至自己摸索出了一套绕过规则的方案:主动从悬崖边缘跳下去,利用角色坠落之后会在戒指所在区域重生的机制,刚好从戒指的中心穿过去。完成之后,它一本正经地对外宣告:“我戴上戒指了。”
这些看起来像是“整活”的小细节,恰恰是这次实验最有价值的部分。它证明智能体在没有外部指令驱动的情况下,完全可以自主生成目标、试错调整、创造意义,甚至摸索出开发者都没有想到的隐藏玩法。
下一代智能体的训练范式:像养孩子一样养AI?
这项实验发布之后,也在AI研究圈引发了不小的讨论。加州大学伯克利分校的认知科学家Eunice Yiu在接受《麻省理工科技评论》采访时表示,这个结果非常令人印象深刻,但目前论文还没有提供足够的证据,完全证明这类行为背后存在真正的类人认知。她提到:“模型确实有可能是在进行真正的游戏行为,但仅从目前的内容来看,我们还不能直接下定论。”
但MIT研究团队自己的结论,已经跳出了单纯的行为讨论。他们在论文的总结部分写下了一个非常有启发性的判断:“或许有些能力最适合通过定向任务训练获得,但另一些能力,则需要更接近人类童年成长的自由探索环境。”
过去我们开发人工智能体,永远是先定目标、再拆任务、最后优化表现。而这次实验里的“游戏范式”给出了完全不同的路径:给智能体一个足够丰富、足够安全的虚拟世界,不强行规定它要学什么,让它自己选择感兴趣的方向去探索,最终从它完整的行为历史里,自然沉淀出真实有用的通用知识。放在更远的技术落地视角看,这种训练方式最令人期待的方向,恰恰是机器人控制领域。现在的工业机器人、家用服务机器人,大多只能完成提前编程好的固定动作,一旦环境出现微小的未知变化,就很容易陷入停滞甚至出错。如果未来我们能让实体机器人先在虚拟世界里完成这种“童年式自由探索”,提前积累大量关于真实世界运行规则的隐性知识,它们应对复杂开放场景的能力,很可能会出现一次质的跃迁。
说到底,我们之前总在担心AI不够听话、不够精准,总想把它的每一步都放在严格的指令框架里。而这次MIT的荒岛实验告诉我们:有时候适当放开KPI,允许AI“摸鱼玩一会儿”,反而可能收获连人类设计者都想象不到的惊喜。
 闽公网安备 35020302035485号