堆代码网讯 传统数据库行业长期维持着相对明确的分工:分析型数据库面向趋势挖掘、业务洞察类场景优化,操作型数据库则专门承载订单、支付等高频实时交易。两类系统彼此独立部署,企业往往需要搭建复杂的数据流转链路才能完成数据同步,不仅运维成本高企,也容易出现数据时效不一致的问题。总部位于德国慕尼黑的数据库初创企业CedarDB正在打破这一延续数十年的行业惯例。其联合创始人兼首席执行官Moritz Sichert在接受TechCrunch采访时明确表示,随着智能体AI的快速普及,能够同时承载事务处理与分析负载的统一数据库,正在从“技术亮点”转变为企业的刚性需求。
 十年技术沉淀,从学术研究走向商业化落地
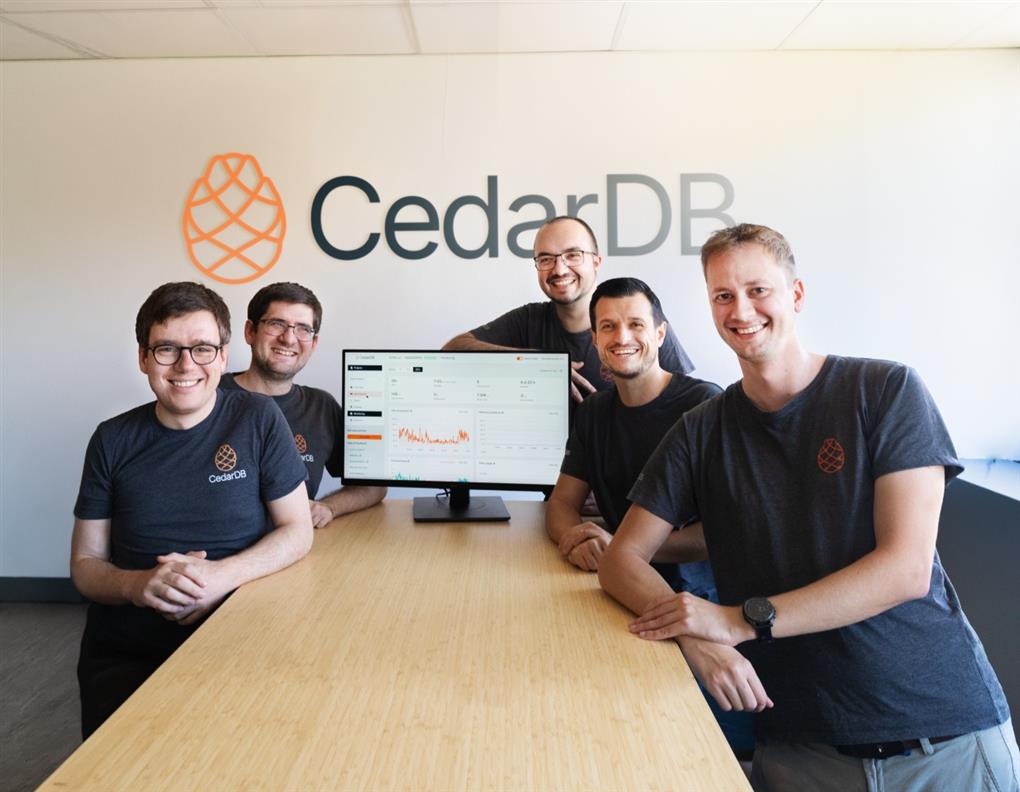
CedarDB的技术源头可以追溯到十年前启动的Umbra研究项目,该项目由慕尼黑工业大学团队从零搭建,核心目标是充分释放现代多核处理器与高速存储的硬件潜力,在处理速度上全面超越传统数据库引擎。依托这一学术成果成立的CedarDB,是典型的高校技术衍生企业,五位联合创始人全部来自原Umbra研究团队。
不同于多数创业公司主打“颠覆性创新”的路径,CedarDB从商业化第一天就把“低迁移成本”作为核心设计原则:在不增加额外CPU、算力和内存占用的前提下实现性能跃升,同时对现有业务系统几乎零改造要求。其中最关键的设计决策,就是实现了与主流开源数据库PostgreSQL的全面兼容。
Moritz Sichert解释,这一设计让现有PostgreSQL用户无需重构应用代码即可完成迁移,大幅降低了企业的切换门槛。而一个意外收获是,这套兼容PostgreSQL的运行逻辑,恰好与大语言模型的训练习惯高度契合,天然适配AI场景下的各类数据调用需求。
从本地部署到云原生,产品路线逐步清晰
从学术团队转向商业化公司的过程中,CedarDB团队并没有一味追求产品发布速度。联合创始人Christian Winter曾在官方博客中提到,离开高校后团队首先确立的优先级清单里,可靠性、容错性和主流工具兼容性排在最前列,远早于云版本等商业化功能的规划。团队内部曾就是否立刻推出云服务产生过激烈争论,最终他们选择先落地本地部署形态。2025年5月,CedarDB同步发布了企业版与免费社区版,同期宣布完成530万欧元(约合600万美元)种子轮融资。其中免费社区版最大支持64GiB数据集,面向数据工程师和中小团队开放使用。
推迟发布的云产品并未被放弃。在完成等待名单用户的多轮测试后,CedarDB在2026年TechCrunch Disrupt大会的舞台上正式宣布CedarDB Cloud开启限量公测,同时这家14人规模的初创团队也加入了Startup Battlefield创业大赛的角逐,与全球20家优质初创企业同台竞技。
巨头同向布局,智能体时代重构数据基础设施
随着CedarDB Cloud的推出,这家德国初创公司开始直面行业头部厂商的竞争。2026年6月,Databricks在Data + AI峰会上正式发布LTAP新数据架构,明确提出面向“智能体时代”,在数据湖的单份存储之上统一承载交易、分析、流处理和操作型数据四类负载。这一产品方向与CedarDB坚持多年的“单库融合”路线高度重合。
Moritz Sichert认为,头部厂商的跟进恰恰印证了市场需求的真实存在。当前企业在部署AI智能体应用时,普遍遇到传统数据栈无法同时满足低延迟事务查询和实时语义分析的痛点,统一架构的数据库正在成为AI落地的核心数据基础设施。据了解,CedarDB现阶段将由现有14人团队服务首批云用户,后续随着客户规模扩大将启动团队扩张,并同步推进下一轮融资。从技术路线的长期追随者,到和行业巨头同步锚定下一代数据架构,这家从慕尼黑实验室走出来的初创公司,正在AI智能体的浪潮中迎来自己的商业化拐点。
 闽公网安备 35020302035485号